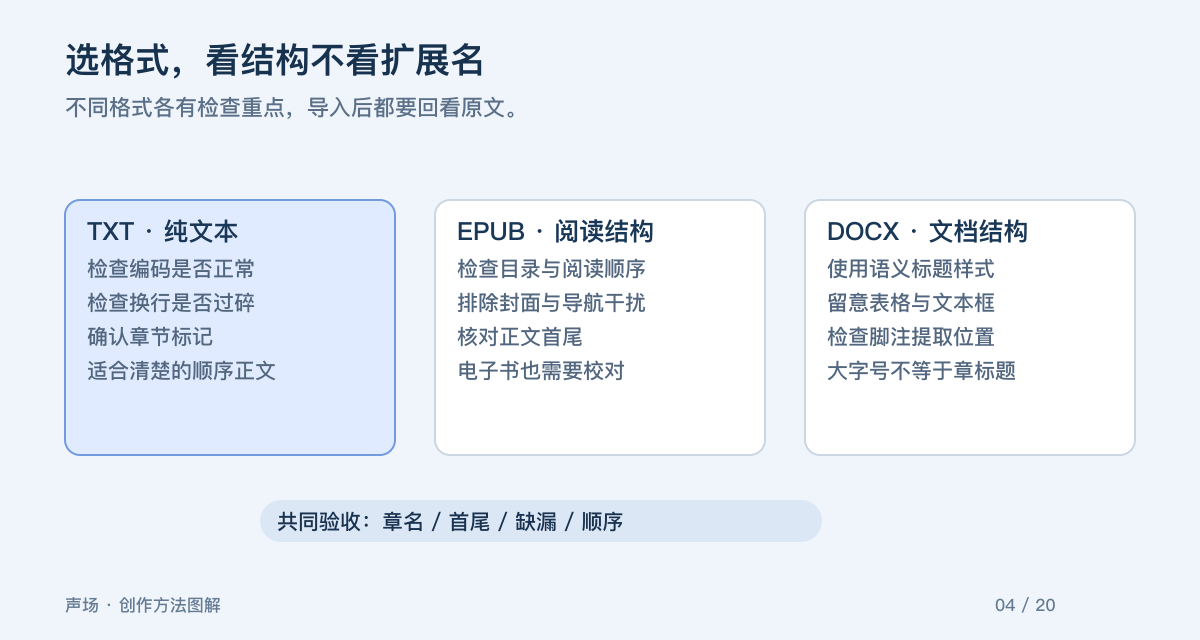
优先选择结构最清楚的合法原稿
同一本内容有多个文件时,优先选择正文完整、章节标题清晰、没有乱码的版本,而不是容量最大的那个。先确认有权把内容制作成音频。格式转换只能改变包装,不能补回缺失正文,也不能解决内容授权问题。声场支持 TXT、Markdown、EPUB 和 DOCX,它们提取后都会进入结构确认与角色复核流程。
TXT 简单,但要看编码和换行
TXT 适合直接编辑,也最容易看出混入的目录、水印与广告。常见问题是编码不匹配产生乱码,或每行都被强制断开。导入前抽查首、中、尾几处,确保人物名字和标点没有异常。标题最好独占一行;不要为了“格式统一”把所有空行和标点删掉,那会让对白边界更难判断。
EPUB 重点检查阅读顺序
EPUB 包含正文文件、目录、图片和元信息,导入时要按书籍定义的阅读顺序提取,而不是按文件名排序。提取之后仍需检查序言、正文、后记和附录是否符合你的制作范围。图片里的文字不会因为出现在电子书中就自然成为可读正文;需要另外整理。受保护或结构异常的文件也不能保证直接导入,不建议尝试绕过文件保护。
DOCX 的标题样式比大字号可靠
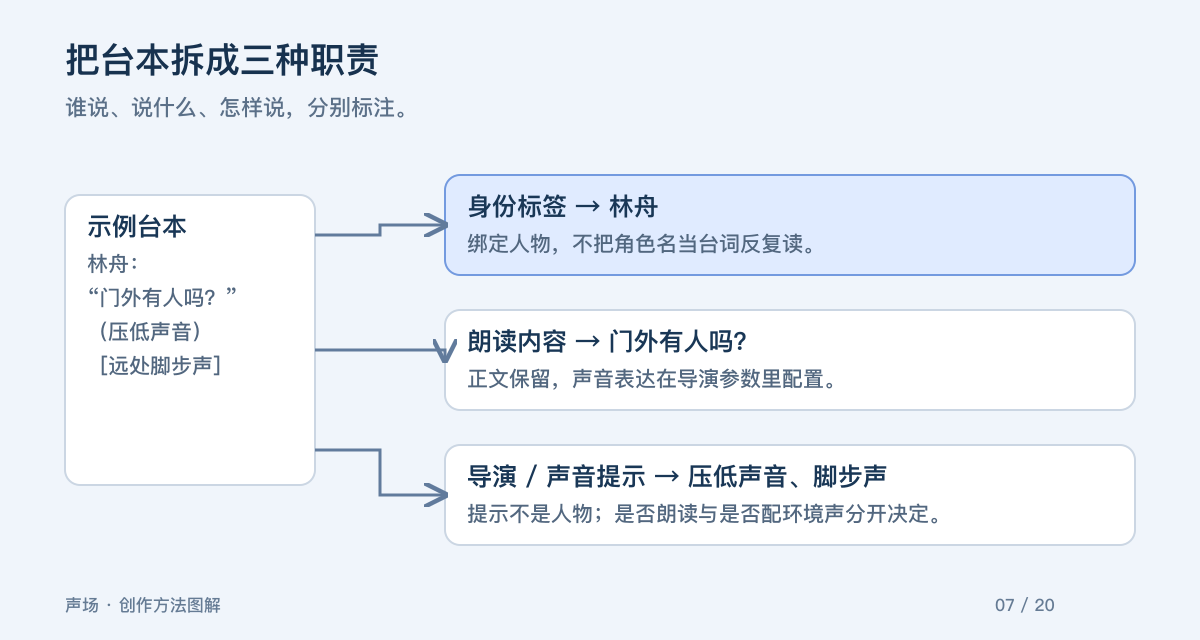
Word 文稿中,“标题一”“标题二”等语义样式比单纯放大字号更有助于识别章节。正文尽量使用正常段落;文本框、复杂表格、脚注和批注可能不按你眼睛看到的顺序提取。如果重要内容放在这些区域,先整理到一份阅读稿中,并在提取结果里逐项核对,不能只看导入成功提示。 如果文稿本身是剧本,可以继续使用台本整理方法明确各类标签的职责。
导入后的共同检查清单
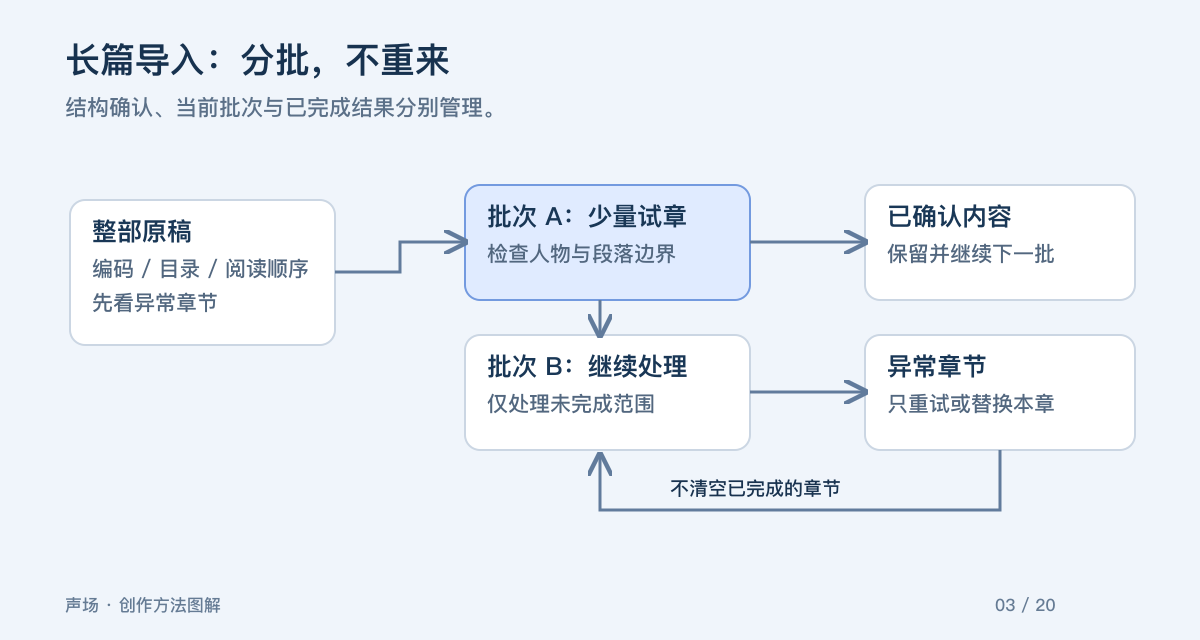
无论选择哪种格式,都要检查章节数、正文首尾、人物名字和特殊符号。Markdown 的标题层级也应清楚,代码块或编辑备注不要当作朗读正文。扫描 PDF 和图片并不等同于结构化文稿;若需要先做文字识别,应另外校对识别结果,避免把错字直接送去生成语音。 长文档整理完成后,按长篇分批导入的节奏验证结构。 实际入口与操作步骤见使用教程。
- 保留原文件和整理后的阅读稿两个版本。
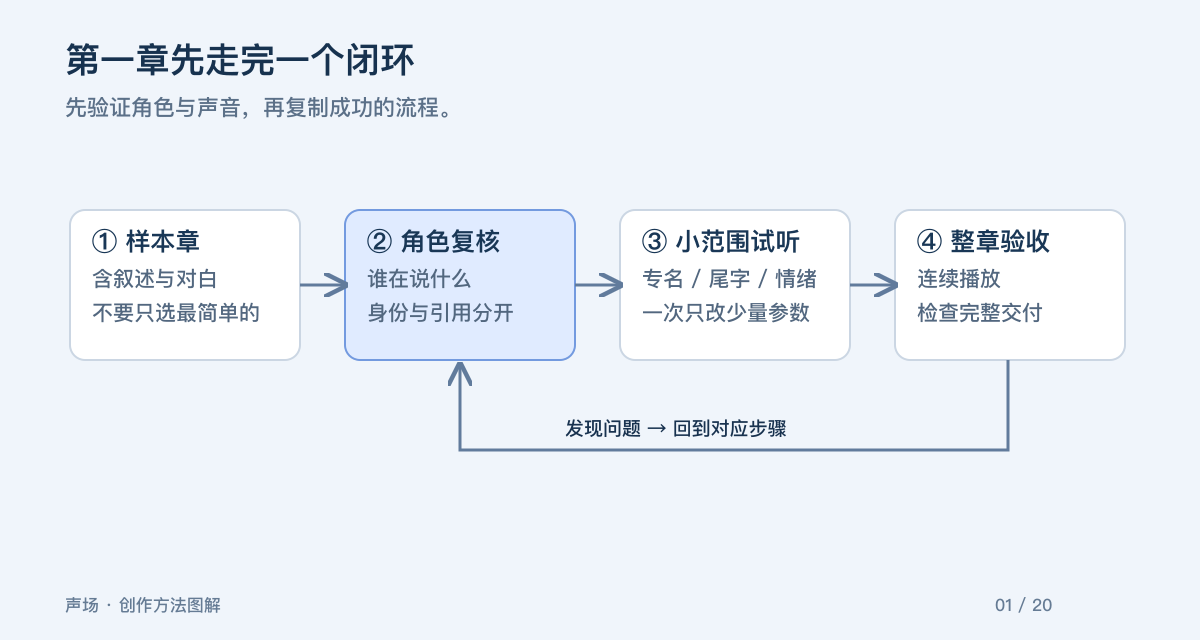
- 先选一个含对白的章节验证,再处理全书。
- 发现提取遗漏,回到原稿确认,不让 AI 猜写缺失部分。
- 手动校准完成后再锁定音色与批量生成计划。