先决定是整理原声,还是制作新声音
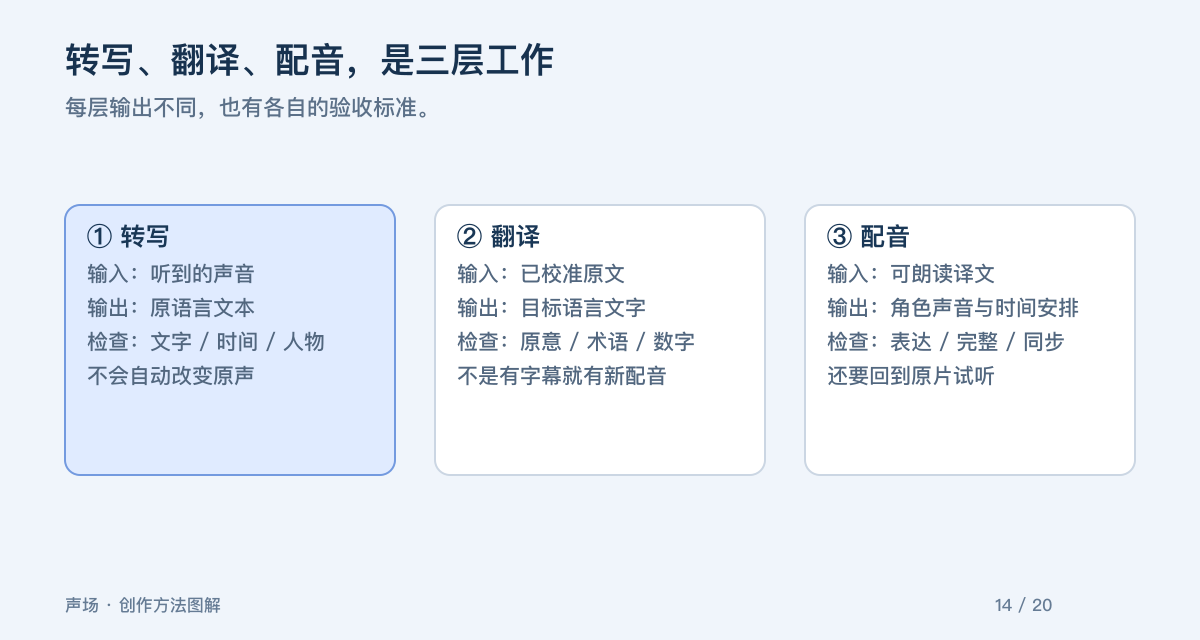
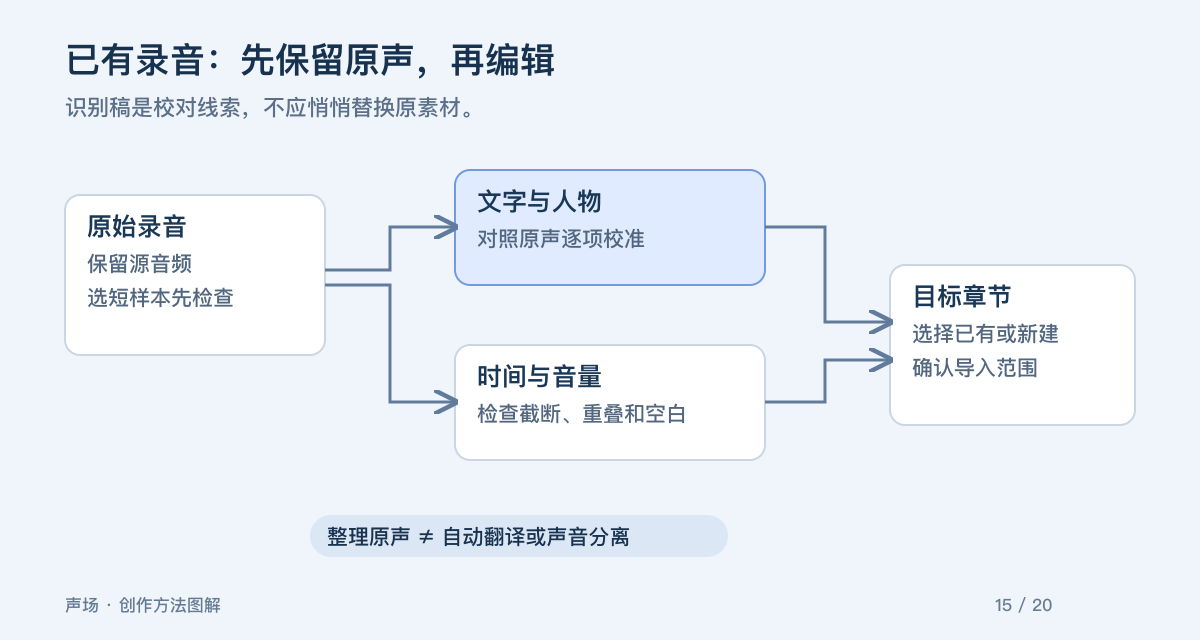
如果已经录好了讲述、对白或声音素材,导入的第一目标通常是保留原声并获得可校对的文字和片段,而不是强制生成 TTS。修改识别文字也不等于录音里对应的话会自动改变。先明确你是要整理片段、修正字幕参考,还是确实需要重配某一句,避免把不同操作混在一起。
准备一段能代表录音质量的样本
声场当前音频导入界面支持 WAV、MP3、M4A、AAC 和 FLAC,单文件上限为 50 MB。先用较短、声音清楚的片段验证,再处理长录音。多人抢话、远距离录制或音乐很响的素材,识别结果可能需要更多人工校对。解析过程包含上传、预处理、语音时间戳与保存,等待时间不能只根据文件大小判断。
文字、人物和时间分别检查
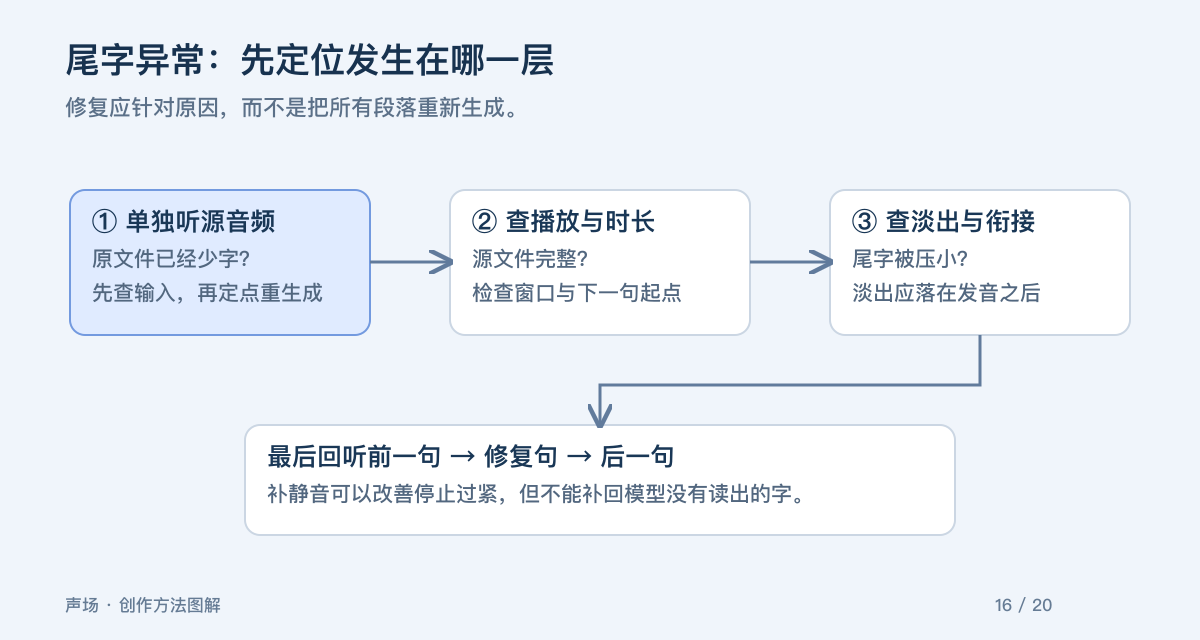
先听完整录音确认内容,再逐段核对识别文字、说话人和开始结束位置。说话人编号或自动建议只是线索,不一定知道录音里真实的人名;无法区分时要人工改正。同一人的不同语气也可能被误分,需要合并映射。时间边界要能容纳完整开头和尾字,不要为了看起来整齐紧贴每一个波峰。 发现句尾缺字或停止过紧时,可按尾字异常检查定位来源。
选择明确的工作台去向
校对后,在导入工作台时选择创作类型、已有或新建作品,以及目标章节。确认本次包括哪些人声片段,是否同时带入环境声和声音事件,并检查角色映射。声场会保留原声音频及其时间、音量等信息进入工作台,不需要先重新生成。导入后检查目标章节,避免误以为素材只停留在解析结果里。
不要把事件标签当成声音分离保证
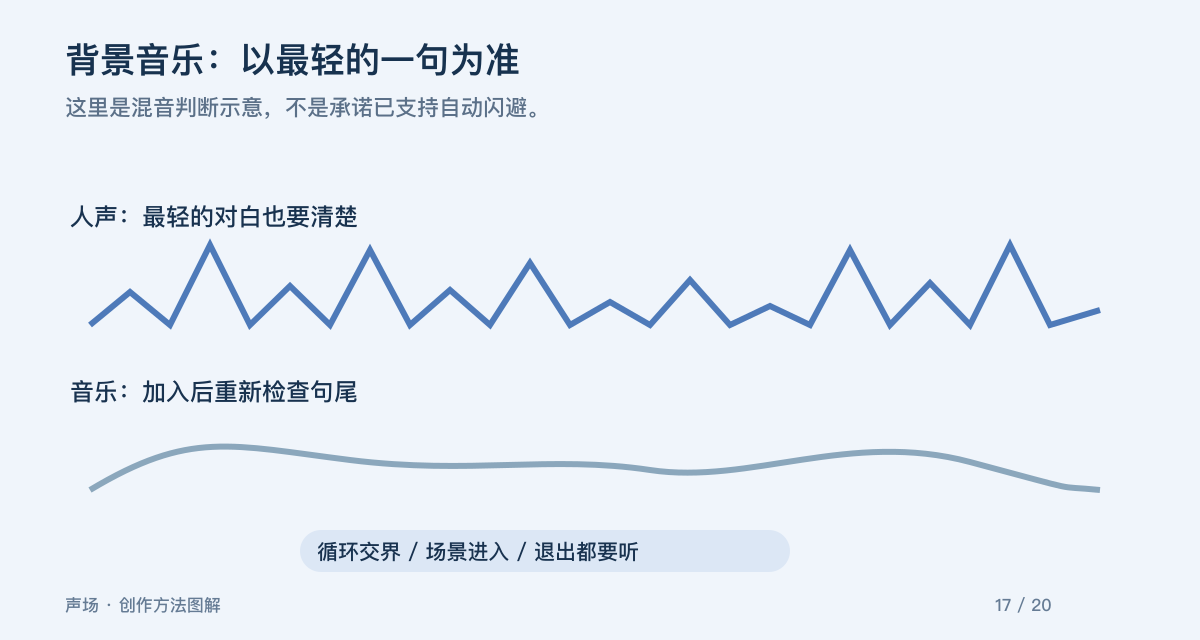
检测到“环境声”或“声音事件”,不意味着已经从混合录音中得到干净、独立的人声或伴奏。重叠录音可能仍含其他声音;当前流程不能承诺自动降噪、精准分离所有声源或将录音直接翻译成另一种语言。需要重配时先保留原始文件和版本,针对小范围处理并重新试听。 目标变化时,先重新确认转写、翻译与配音的区别,再选择处理入口。 需要文字或视频制作入口时,可从使用教程继续。
- 导入前确认素材使用授权,敏感录音只在必要范围内处理。
- 单段检查边界,连续播放检查顺序和重复。
- 目标作品、章节与角色映射确认后再提交。
- 先验证真实录音,不用内置演示效果推断任何录音都能相同处理。